本文をもとにGemma 3が要約しています
- JavaScript側で毎フレーム大量のオブジェクトが生成されている。
- オブジェクトの生成がボトルネックとなり、フレーム落ちやCPU負荷の増加を引き起こしている。
- オブジェクトの再利用、Float32Arrayの利用、staticデータとframeごとのデータの分割などの対策を提示している。
サイトのデザインをリニューアルしたとき、線画や3Dオブジェクトを足していくうちに、初めて使う技術を試したくなりました。仕事では派手な演出をほとんど扱いません。今回は制約を外して、WebGL(ブラウザからGPUで描画するAPI)と Pixi.js(WebGLで2Dを描くライブラリ)を使ってみることにしました。
スマホで開いた瞬間に、アニメーションが落ちました。デスクトップでも、やや重たい挙動が出ていました。毎秒60回、数千個の粒子を動かすのは、モバイルでは厳しいのだろうか、と思いました。
同じスタックでもっと派手な演出をしているサイトを調べると、動いている例は結構ありました。実装のどこかに原因があるはずです。見ただけでは、描画処理なのかJavaScript側なのかは分かりません。最初に疑っていた場所とは違うところに原因があり、中身が興味深かったので、備忘録として残します。
1. 症状と環境
対象は、このサイトのロゴマークの粒子アニメーションです。Pixi.js v8のWebGLレンダラーで、約3000個の粒子を回しています。各粒子は毎フレーム、渦巻きの回転、吸い込みの変位、3D回転、画面座標への投影を経て描画されます。
主な症状は次の通りです。
- 60FPSは維持できるものの、ところどころフレームが重く感じる
- iPhoneではスクロール中にクラッシュする(Jetsam。メモリ不足時の強制終了)
- 十数秒触っていると、本体が発熱する
粒子アニメーションは、GPUだけで完結しません。頂点シェーダー(GPU上で頂点ごとに動く描画プログラム)へ座標を渡す前に、JavaScript側で毎フレームの計算が走っています。ボトルネックがGPUなのかJavaScriptなのかで、打つ手が変わります。まず、どちらなのかを特定します。
2. とりあえず計測
計測しやすいデスクトップから、記録を取ります。ボトルネックがGPUなのか、JavaScriptなのかを特定するためです。
Chrome DevTools Protocol(CDP。ブラウザを外部から操作・計測するAPI)のTracing APIで記録しました。Chromeをremote debugging port付きで起動し、Node.jsの計測スクリプトから接続します。計測区間は10秒、粒子数は約3000で固定です。
記録を見ると、GPUの描画コマンドより先に、メインスレッドのanimation loopが目立ちます。粒子ごとの座標計算がフレーム時間の大半を占め、その合間に GC(Garbage Collection。不要になったメモリの回収)が繰り返し挟まっています。種類は Minor GC(短命なオブジェクトを対象にした回収)です。
drawFrame(1フレームの粒子更新にかかったJavaScript時間)の平均は約2.3msです。Minor GCは234回でした。2.3msは、60FPS(1フレームあたり16.6ms)の予算に対して枠内です。
ただし、メインスレッドは忙しく、GCも頻繁です。疑うべきは頂点シェーダーより、JavaScript側の hot path(毎フレーム必ず通る処理経路)でした。
改善後の同じ条件での数字は、9章に載せています。
3. 原因は毎フレームの大量allocation
hot pathのコードを読むと、allocation(オブジェクト用のメモリ確保)が多すぎることが、すぐに分かりました。粒子1個の座標を計算するたびに、新しいオブジェクトを返していたんです。
// before: 呼ぶたびに新しいオブジェクトを生成する
const applyRestOrientation = (localX, localY, localZ, angle) => {
  // ...傾きと回転の計算...
  return {
    x: localX * angleCos - inclinedY * angleSin,
    y: localX * angleSin + inclinedY * angleCos,
    z: inclinedZ,
  };
};
この関数単体は、何の問題もありません。1回の生成は軽く、普通のコードです。ただし、問題は呼ばれる回数です。
粒子は約3000個あります。1粒子につき、渦巻き位置、吸い込みの変位、画面変換、描画フレームなど、中間結果のオブジェクトが数個生まれます。60FPSで回すと、毎秒3000 × 数個 × 60回です。
つまり、毎秒100万個規模の短命オブジェクトが生成されては捨てられます。1回は軽くても、この回数だとhot pathでは無視できません。
4.生成したオブジェクトはすぐには消えない
JavaScriptのオブジェクトは、使い終わってもすぐには消えません。エンジンのGCが「もう参照されていない」と判断してから、回収します。この回収でも、メインスレッドに負荷がかかります。JavaScriptは、基本的にシングルスレッドだからです。
まず、実行環境の前提です。同じChromeでも、デスクトップとiPhoneではエンジンが違います。デスクトップは V8(ChromeのJavaScriptエンジン)です。iPhone側のブラウザエンジンはWebKitで、JavaScriptの実行は JavaScriptCore(WebKitのJavaScriptエンジン)が担います。
GCの実装は厳密には違います。ただし、どちらも 世代別GC(新しいオブジェクトと古いオブジェクトを分けて回収する方式)で、短命なオブジェクトを安く回収する設計です。
V8の世代別GCは、新しいオブジェクトをまず young generation(新しいオブジェクトを置く領域)に置きます。そこが埋まると、Minor GCの Scavenger(生き残ったオブジェクトだけを別領域へコピーする回収)が走ります。「ほとんどのオブジェクトはすぐ死ぬ」前提では、この方式は効率的です。
JavaScriptCoreも世代別ですが、生存オブジェクトをコピーで移動させません。sticky mark bit(前回の回収を生き延びたかを示す印)で管理し、eden(新規割り当て領域)だけを回収します。ただし、「新しいオブジェクトが増えるほど、young generationの回収が頻発する」点は同じです。
参考にしたのは、V8の Trash talk です。JavaScriptCore側は、Understanding Garbage Collection です。
両者のGCで起きうる問題は、回収中に参照関係が変わると、まだ使っているオブジェクトを消してしまうことです。だから、回収のあいだメインスレッドを短く止め、ヒープ(オブジェクトを置いているメモリ領域)の状態を固定します。この停止を stop-the-world(回収中に実行を止めてヒープを固定する処理)と呼びます。
V8は、Minor GC(Scavenger)を並列化しています。JavaScriptCoreは、コンカレントGC(Riptide。実行と並行して回収を進める方式)です。どちらも、停止時間を短くする工夫です。
ただし、毎秒100万個のペースで短命オブジェクトを作ると、young generationがすぐ埋まり、回収の回数そのものが増えます。1回の停止は短く済みます。毎秒20回以上挟まると、計算時間とは別にメインスレッドの時間を使います。
60FPSなら、1フレームあたり約16.6msで処理を終えないと、次の描画に間に合いません。ただし、今回のデスクトップ記録では、drawFrameにGCを足しても16.6msは超えていません。問題は「GCがフレームを落とした」ことより、「毎フレーム大量のオブジェクトを捨てている」ことでした。
モバイルで症状が強く出たのは、エンジンの違いよりリソースの違いだと考えています。CPUが遅く、冷却も電力も限られるため、同じallocationのペースでも相対コストが上がります。発熱の主因は、GCの合計時間より、毎秒100万個規模のオブジェクト生成そのものだと思っています。モバイル側のmsは計測していないので、ここは体感です。
5. 対策1、オブジェクトを再利用する
まず、毎回新しいオブジェクトを返すのをやめました。呼び出し側が持つオブジェクトへ、書き込むようにしています。
// after: 呼び出し側が渡したオブジェクトへ書き込む(*Into パターン)
const applyRestOrientation = (localX, localY, localZ, angle, result) => {
  // ...傾きと回転の計算...
  const output = result ?? {};
  output.x = localX * angleCos - inclinedY * angleSin;
  output.y = localX * angleSin + inclinedY * angleCos;
  output.z = inclinedZ;
  return output;
};
animation loop側では、初期化時に確保した scratchオブジェクト(使い回し用の作業領域)を、毎フレーム渡します。
// 初期化時に1度だけ確保する
const scratch = {
  swirledPosition: { x: 0, y: 0, z: 0 },
  dispersedPosition: { x: 0, y: 0, z: 0 },
  transform: {},
};

// 毎フレーム、同じオブジェクトへ上書きする
const position = calculateSwirlPositionInto(scratch.swirledPosition, args);
これで、粒子数 × 中間オブジェクト数ぶんの、毎フレームのallocationが消えます。
注意点は、書き込み先を共有するので、前フレームの値が残ることです。全フィールドを毎回書き切るか、リセットを挟まないと、残った値が次のフレームに混ざります。
6. 対策2、Float32Arrayへ移行する
allocationを消しても、まだ改善の余地がありました。粒子データの持ち方です。
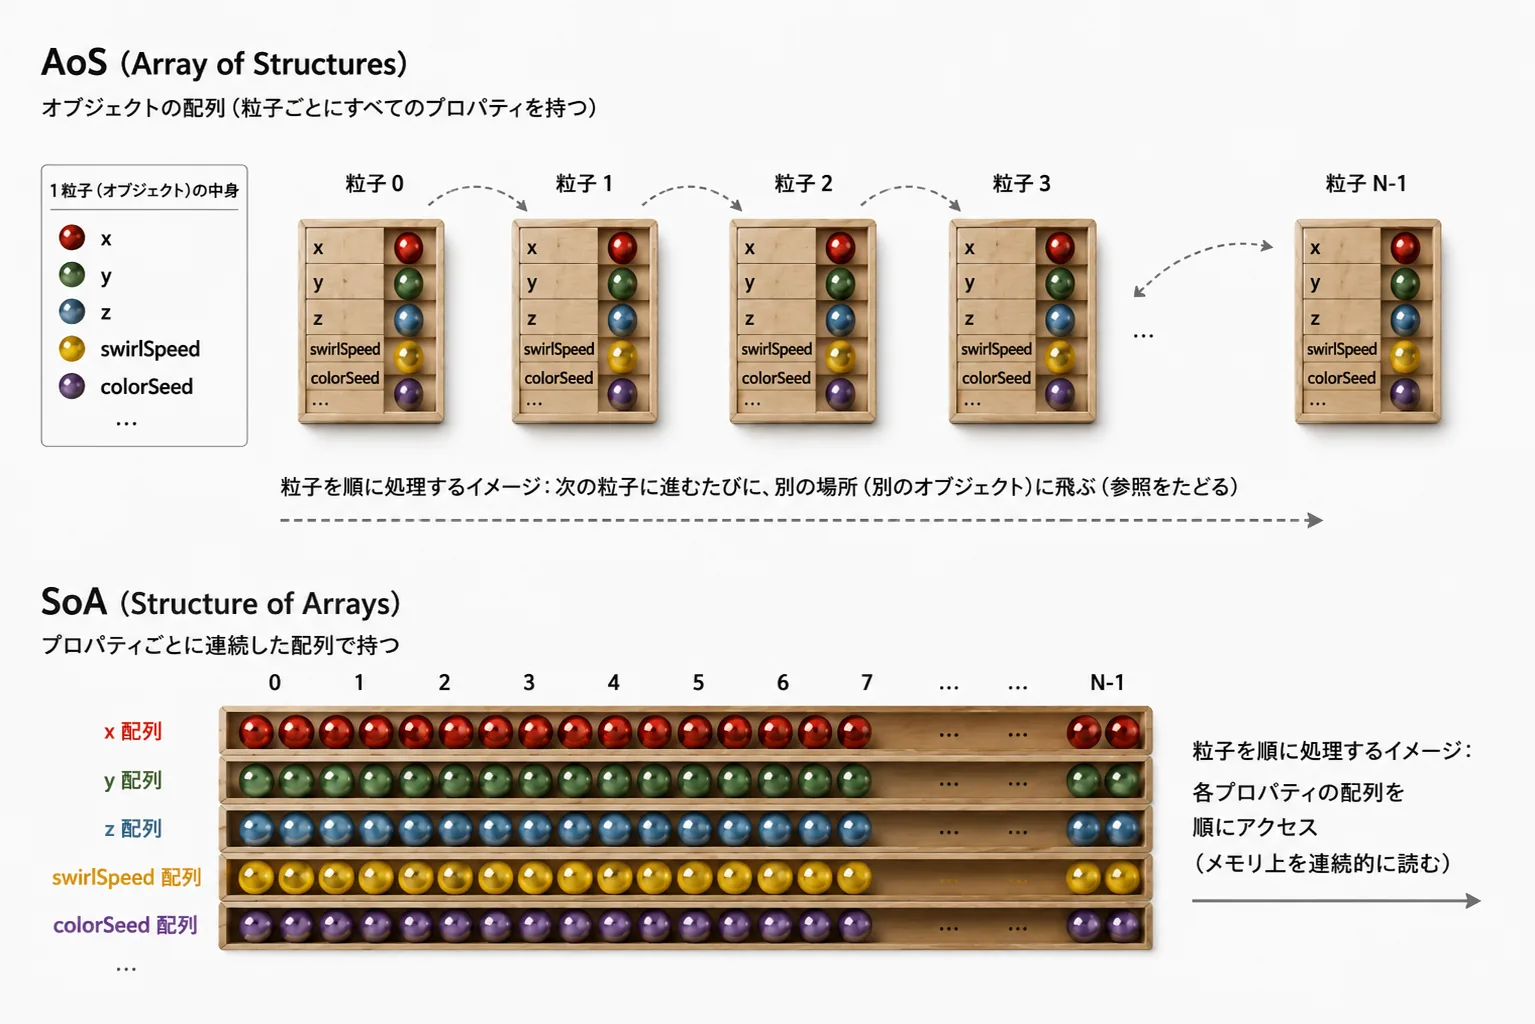
もともと粒子は、「1粒子 = 1オブジェクト」の配列で持っていました。この持ち方を AoS(Array of Structures。構造体の配列)と呼びます。対して、プロパティごとに数値配列へまとめる持ち方が SoA(Structure of Arrays。配列の構造体)です。
// AoS: オブジェクトの配列
const particles = [
  { x: 1.2, y: 0.4, z: -0.8, swirlSpeed: 0.001, colorSeed: 0.3 },
  // ...3000個...
];

// SoA: プロパティごとの Float32Array
const soa = {
  count: 3000,
  restX: new Float32Array(3000),
  restY: new Float32Array(3000),
  restZ: new Float32Array(3000),
  swirlSpeed: new Float32Array(3000),
  colorSeed: new Float32Array(3000),
};
Float32Arrayは、32bit浮動小数点数を連続したメモリに敷き詰める TypedArray(型付き配列)です。通常のオブジェクトと違い、要素は生の数値としてバッファに並び、参照を挟みません。
hot pathにおけるSoAの利点は、2つあります。
1つ目は、メモリ局所性(処理する値がメモリ上で近くに並ぶこと)です。全粒子を順に処理するとき、SoAなら各プロパティ(x、y、z)が連続した数値になります。AoSだと配列の中身は参照なので、粒子を進めるたびに別のオブジェクトへ飛びます。
2つ目は、GC対象が減ることです。3000個のオブジェクトが十数本のTypedArrayに置き換わり、GCが追跡する対象がほぼ消えます。
| 観点 | AoS(オブジェクト配列) | SoA(Float32Array) |
|---|---|---|
| 書きやすさ・読みやすさ | 高い | 添字管理が必要 |
| メモリ局所性 | 低い | 高い |
| GC負荷 | 粒子数ぶんのオブジェクト | 配列数本のみ |
| 向いている場所 | 初期化、少数データ | hot path、数千件の数値計算 |
一方で、SoAはコードの可読性を落とします。particle.x が soa.restX[index] になり、粒子の追加や削除も面倒になります。全部をSoAにするのではなく、毎フレーム数千件を処理するループだけをSoAにする、という線引きが実用的です。
7. 対策3、staticなデータとframeごとのデータを分ける
SoA化の過程で気付いたのは、データの更新頻度が違うことです。粒子のデータは、2種類に分かれます。
- staticなデータ(初期化後は変わらない値)。基準位置(restX/Y/Z)、渦巻き速度、色のシードなどです。初期化時に決まり、以後は変わりません
- frameごとのデータ(毎フレーム変わる値)。回転角、吸い込みの進行度、経過時間などです
改善前のコードは、この2つを区別せず、毎フレーム全部を計算し直していました。分離後は、staticな値を初期化時に1度だけFloat32Arrayへ詰め、毎フレーム更新するのは少数のパラメータだけにしました。
// 初期化時に1度だけ: staticな値をpackする
const soa = packParticleSoA(positions, layoutScale);

// 毎フレーム: 変わる値だけを更新する(配列は再利用し、要素へ代入する)
uniforms.uRotationTrig[0] = rotationTrig.cosX;
uniforms.uRotationTrig[1] = rotationTrig.sinX;
uniforms.uSuctionProgress = suctionProgress;
さらに、粒子ごとの座標計算そのものを頂点シェーダーへ移しました。staticなデータは、GPUの インスタンス属性(粒子ごとに1組持たせる頂点データ)として、初期化時に転送します。CPUが毎フレーム触るのは、回転や時刻などの uniform(全粒子共通のパラメータ)だけです。3000粒子ぶんのCPUループ自体が消え、JavaScript側のhot pathは数個の代入になりました。
この分離は、データ構造を更新頻度に合わせて決める、という話でもあります。毎フレーム変わらない値を、毎フレーム計算する必要はありません。変わる値だけを、変わる頻度に合った場所(uniform)に置きます。先に更新頻度を見て、そこからデータ構造を決めています。
8. 対策4、端末ごとに粒子数を変える
ここからは、仕事量そのものを減らします。対策1から3までは、1フレームの処理を速くする話でした。最後は、出す粒子の数そのものを疑います。
いくらhot pathを磨いても、モバイルのGPUとCPUはデスクトップより遅くなります。同じ3000粒子を出す前提を、疑うべきでした。このサイトでは、ポインタ精度の メディアクエリ(入力装置の粗さで分岐するCSSの条件)で端末を推定し、粒子数とFPS上限を切り替えています。
// pointer: coarse(タッチ主体の端末)なら粒子数とFPS上限を落とす
const PARTICLE_COUNTS = { high: 3000, balanced: 1600, safe: 800 };

const resolveProfile = () =>
  window.matchMedia("(pointer: coarse)").matches
    ? { particleCount: PARTICLE_COUNTS.balanced, maxFps: 45 }  // モバイル
    : { particleCount: PARTICLE_COUNTS.high, maxFps: 60 };     // デスクトップ
モバイルでは、粒子数を1600に、FPS上限を45に落とします。粒子数は3000から1600へ、およそ半分になります。毎フレームの計算も、GPUの描画負荷も、それに合わせておよそ半分になります。45FPSは、装飾のアニメーションとしては体感であまり気になりません。
pointer: coarse は、「タッチが主入力の端末か」しか分かりません。端末の実性能は測れません。ハイエンドのタブレットでも、粒子は減ります。それでも採用したのは、実行時ベンチマークで性能を測る方式だと、初回描画が遅れるうえ、測定自体が不安定だからです。装飾用途なら、安定した推定の方が実害は少ないと判断しました。
9. 改善前後を計測して答え合わせ
改善前のコードと現行HEADを、2章と同じCDPのTracingで記録しました。デスクトップのChrome、実効粒子数は3000、計測区間は10秒です。集計しているのは、トップレベルの MinorGC と MajorGC だけです。
粒子数が同一なので、この表に対策4(粒子数の削減)の効果は含まれていません。対策1から3までの累積です。
見る列は、drawFrame(1フレームの粒子更新にかかったJavaScript時間)と、Minor GCの回数です。FPSとGC合計時間は、表のあとに分母を置いて読みます。
| 指標 | 改善前 | 現行 HEAD | 改善率 |
|---|---|---|---|
| 実効粒子数 | 3000 | 3000 | 同一 |
| 実効 FPS | 58.5 | 58.7 | ほぼ同等 |
drawFrame 平均 | 2.297 ms | 0.367 ms | 約84.0%短縮 |
drawFrame P95 | 3.080 ms | 0.700 ms | 約77.3%短縮 |
drawFrame P99 | 3.400 ms | 0.914 ms | 約73.1%短縮 |
MinorGC 回数 | 234回 | 5回 | 約97.9%減 |
MajorGC 回数 | 0回 | 0回 | — |
| GC合計時間 | 85.412 ms | 2.752 ms | 約96.8%短縮 |
| 1回のGC最大時間 | 0.761 ms | 0.794 ms | ほぼ同等 |
まず、FPSです。58.5から58.7へ、ほぼ動いていません。改善前から約60FPSを維持できていたので、この計測の範囲では、FPSが動かなくても不思議ではありません。
次に、drawFrame です。平均は2.297msから0.367msへ下がり、P99(全フレームのうち遅い方から1%の境目)でも1ms未満です。10秒(約585フレーム)では、メインスレッド上の更新時間が約1秒ぶん減っています。
drawFrame は、更新関数の内側だけを performance.now() で測っています。CDP上のGC停止は、この数字に入りません。減ったのはGC待ちではなく、毎フレームオブジェクトを作っていたCPU時間です。
16.6msの予算に対して、改善前の2.3msも改善後の0.4msも枠内です。P99の3.4msに、GC最大0.76msを足しても約4.2msです。この表は、「16.6msを超えてフレームが落ちた」とは言えません。見立てが外れました。
Minor GCは、234回から5回です。4章の「allocationが多いと、young generationの回収が頻発する」は、回数の減少と対応します。Major GCはどちらも0回で、問題はyoung generation側に寄っていました。
GC合計85msは、10秒の0.85%、1フレームあたり平均約0.15msです。経過した実時間としても、1フレームの予算としても、デスクトップのFPSを動かした量ではありません。
1回のGC最大時間は、0.761msと0.794msで、ほぼ同じです。停止が短くなったのではなく、回数が減った、ということです。
10. まとめ
コードは、次の順に積んでいます。オブジェクトの再利用、Float32ArrayへのSoA化、staticなデータとframeごとのデータの分離、粒子計算の頂点シェーダーへの移行です。そのうえで、端末ごとに粒子数を変えています。
9章の表は、デスクトップで粒子数3000、対策1から3までを見た記録です。drawFrame は約2.3msから0.4msになり、Minor GCは234回から5回に減りました。FPSは約60のままです。改善前から枠内だったので、この計測でFPSが動かなくてもおかしくありません。
Minor GCの回数は、allocation仮説の証拠です。「GCがデスクトップのFPSを動かした」の証拠ではありません。9章の合計85msは、10秒の経過時間としても、1フレームの16.6msとしても、その量ではないからです。
モバイルのフレーム落ちは、同じ条件では測っていません。hot pathを薄くしたあとに粒子数も落としていて、体感としてはほぼ解消しています。当初の目的は達成したので、計測までは進めていません。
いまのanimation loopは、回転や時刻などのuniformを更新する処理が中心です。見るときの基準は、次のとおりです。
- 「モバイルだから重い」で止めず、ボトルネックがGPUかJavaScriptかを先に特定します
- allocationは、1回の軽さではなく、毎フレーム × 要素数の回数で見ます。60FPSで数千粒子なら、毎秒100万個規模になります
- 関数のmsだけでなく、Minor GCの回数も見ます。回数は、allocationの圧力の証拠になります
- オブジェクトの再利用とSoAは可読性を落とすので、hot pathに限ります
- データ構造は更新頻度に合わせ、staticな値とframeごとの値を分けます
- 速くするだけでなく、端末に応じて仕事量そのものを減らします
数える対象は、「そのコードは毎フレーム × 要素数で何回走るか」です。モバイル側の成否は、体感として残っています。次に触るときは、同じ条件で測って、必要なら最適化します。
ソース
- Trash talk: the Orinoco garbage collector · V8(世代別GC、Minor GC / Scavengerの仕組み)
- Orinoco: young generation garbage collection · V8(young generationと並列Scavenger)
- Understanding Garbage Collection in JavaScriptCore From Scratch · WebKit(世代別GC、sticky mark bit、eden回収)
- Introducing Riptide: WebKit’s Retreating Wavefront Concurrent Garbage Collector · WebKit(JavaScriptCoreのコンカレントGC)
- TypedArray - MDN Web Docs(Float32ArrayなどTypedArrayの仕様)